机器学习分类与聚类(PICU临床数据应用)
Published:
项目背景
PICU临床数据包含患者年龄、实验室指标等多维度信息,通过机器学习可实现两大核心目标:一是预测患者住院死亡风险(分类任务),辅助临床风险评估;二是基于实验室指标对患者进行无监督分组(聚类任务),挖掘潜在临床亚型。本项目基于13258条患者数据,系统实现数据预处理、多模型分类、K-Means聚类及效果评估,完整覆盖机器学习核心流程。
代码实现
编程库
from collections import Counter
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, recall_score, roc_auc_score, confusion_matrix, roc_curve
from sklearn.metrics import accuracy_score, recall_score, roc_auc_score, confusion_matrix, roc_curve
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
import warnings
warnings.filterwarnings("ignore")
1.数据读取
读取PICU临床数据,包含临床指标和结局变量
#读取包含感兴趣的临床指标的数据集
path = "data.xlsx"
data = pd.read_excel(path)
2.数据统计
检查数据的维度、列名和缺失值情况。 对结局变量 HOSPITAL_EXPIRE_FLAG 的分布进行计数。
# 检查数据维度
print("数据维度:", data.shape)

# 检查缺失值情况
print("\n缺失值统计:")
print(data.isnull().sum())

# 检查结局变量分布
print("\n结局分布:")
print(data['HOSPITAL_EXPIRE_FLAG'].value_counts())
| 统计维度 | 数值/描述 |
|---|---|
| 数据集维度 | 13258(样本) × 7(变量) |
| 无缺失值字段 | age_month、HOSPITAL_EXPIRE_FLAG |
| 实验室指标缺失范围 | 4587-4642条(缺失率约34.6%-35.0%) |
| 结局变量分布(存活) | 12478例(占比94.1%) |
| 结局变量分布(死亡) | 780例(占比5.9%) |
3. 分类任务:预测患者住院死亡风险
3.1. 数据预处理
# 使用均值填充缺失值
datadf = pd.DataFrame(data, columns=data.columns)
data_imputed = data.fillna(datadf.median())

# X:特征矩阵,包含所有样本的所有特征
X = data_imputed.drop('HOSPITAL_EXPIRE_FLAG', axis=1)

# y:目标变量向量,包含所有样本的死亡标志
y = data_imputed['HOSPITAL_EXPIRE_FLAG']

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
3.2. 模型训练与评估
分别使用 逻辑回归、随机森林 和 支持向量机 这三种算法进行模型训练,并对每个模型在测试集上的表现进行评估。
# --- 逻辑回归 (Logistic Regression) ---

# 1. 实例化与训练
# 创建逻辑回归模型对象
log_reg = LogisticRegression(

    penalty='l2',
    C=1.0,
    l1_ratio=None,
    solver='lbfgs',
    max_iter=1000,
    class_weight=None,
    fit_intercept=True,
    random_state=0,
    n_jobs=None,
    verbose=0,
    multi_class='auto'
)

# 使用训练数据训练模型
log_reg.fit(X_train, y_train)
# 2. 预测
y_pred_lr = log_reg.predict(X_test)

# 3. 评估
accuracy_lr = accuracy_score(y_test, y_pred_lr)

# 计算召回率:正确预测的正样本数 / 实际正样本数
recall_lr = recall_score(y_test, y_pred_lr)

# 计算ROC AUC分数:ROC曲线下面积,衡量分类器整体性能
roc_auc_lr = roc_auc_score(y_test, y_pred_lr)


# 打印评估结果,使用f-string格式化输出,保留4位小数
print(f"逻辑回归 - 准确率: {accuracy_lr:.4f}, 召回率: {recall_lr:.4f}, AUC: {roc_auc_lr:.4f}")
逻辑回归 - 准确率: 0.9412, 召回率: 0.0321, AUC: 0.5150
# --- 随机森林 (Random Forest) ---

# 1. 实例化与训练
rf = RandomForestClassifier(

    n_estimators=100,
    bootstrap=True,
    oob_score=False,
    criterion='gini',
    max_depth=None,
    min_samples_split=2,
    min_samples_leaf=1,
    max_features='sqrt',
    max_leaf_nodes=None,
    class_weight=None,
    min_weight_fraction_leaf=0.0,
    n_jobs=None,
    random_state=0,
    verbose=0,
    warm_start=False
)

# 使用训练数据训练随机森林模型
rf.fit(X_train, y_train)
# 2. 预测
y_pred_rf = rf.predict(X_test)

# 3. 评估
# 计算随机森林模型的准确率
accuracy_rf = accuracy_score(y_test, y_pred_rf)

# 计算随机森林模型的召回率
recall_rf = recall_score(y_test, y_pred_rf)

# 计算随机森林模型的ROC AUC分数
roc_auc_rf = roc_auc_score(y_test, y_pred_rf)


# 打印随机森林的评估结果
print(f"随机森林 - 准确率: {accuracy_rf:.4f}, 召回率: {recall_rf:.4f}, AUC: {roc_auc_rf:.4f}")
随机森林 - 准确率: 0.9404, 召回率: 0.0449, AUC: 0.5206
# --- 支持向量机 (SVM) ---

# 1. 实例化与训练
svc = SVC(

    C=1.0,
    kernel='linear',
    degree=3,
    gamma='scale',
    coef0=0.0,
    shrinking=True,
    probability=False,
    tol=0.001,
    max_iter=-1,
    class_weight=None,
    cache_size=200,
    verbose=False,。
    decision_function_shape='ovr',
    random_state=0

)
# 使用训练数据训练SVM模型
svc.fit(X_train, y_train)

# 2. 预测
# 使用训练好的SVM模型对测试集进行预测
y_pred_svc = svc.predict(X_test)

# 3. 评估
# 计算SVM模型的准确率
accuracy_svc = accuracy_score(y_test, y_pred_svc)

# 计算SVM模型的召回率
recall_svc = recall_score(y_test, y_pred_svc)

# 计算SVM模型的ROC AUC分数
roc_auc_svc = roc_auc_score(y_test, y_pred_svc)

# 打印SVM的评估结果
print(f"支持向量机 - 准确率: {accuracy_svc:.4f}, 召回率: {recall_svc:.4f}, AUC: {roc_auc_svc:.4f}")
支持向量机 - 准确率: 0.9412, 召回率: 0.0000, AUC: 0.5000
4. 无监督聚类:患者分群
4.1. 数据预处理
# 1. 选择用于聚类的特征
features = ['lab_5237_min','lab_5227_min','lab_5225_range','lab_5235_max','lab_5257_min']

# 从原始数据中提取选定的特征列
data_clustering = data[features]

# 2. 均值填充
imputer = SimpleImputer(strategy='mean')
# 使用均值填充缺失值
data_clustering_imputed = pd.DataFrame(imputer.fit_transform(data_clustering), columns=features)

# 3. 标准化数据
scaler = StandardScaler()
data_clustering_scaled = scaler.fit_transform(data_clustering_imputed)
4.2. 确定最佳聚类数
# 计算不同簇数下的WCSS

wcss = []

for i in range(1, 11):

    kmeans = KMeans(n_clusters=i, init='k-means++', random_state=0)
    kmeans.fit(data_clustering_scaled)
    wcss.append(kmeans.inertia_)

# 绘制肘部图
plt.figure(figsize=(10, 5))

# 绘制K值与WCSS的关系曲线
plt.plot(range(1, 11), wcss, marker='o', linestyle='--')

# 设置图形标题
plt.title('Elbow Method')

# 设置x轴标签
plt.xlabel('Cluster Number')

# 设置y轴标签
plt.ylabel('WCSS')

# 添加网格线,便于读取数值
plt.grid(True)

# 显示图形
plt.show()
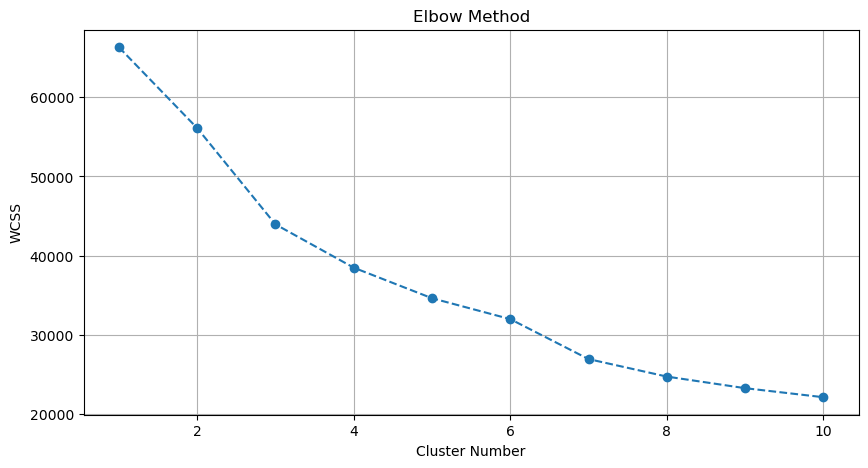 从肘部图可以看出,K=4 是一个比较明显的"拐点",之后曲线下降趋于平缓。因此,选择4作为最佳簇数。
# 1. 设定最佳 K 值
n_clusters = 4 # <-- 根据肘部图观察结果,3是一个合理的选择

# 2. 最终聚类
# 使用最佳簇数进行聚类
kmeans = KMeans(n_clusters=n_clusters, init='k-means++', random_state=0)

# 对标准化数据进行聚类并获取聚类标签
clusters = kmeans.fit_predict(data_clustering_scaled)


# 3. 评估结果
wcss_final = kmeans.inertia_

# 计算轮廓系数
silhouette_avg = silhouette_score(data_clustering_scaled, clusters)

# 打印聚类评估结果
print(f"最佳簇数 K = {n_clusters}")
print(f"最终 WCSS: {wcss_final:.2f}")
print(f"轮廓系数: {silhouette_avg:.4f}")
最佳簇数 K = 4 最终 WCSS: 38487.09 轮廓系数: 0.3151