临床数据分析与回归建模(PICU临床数据应用)
Published:
项目背景
儿科重症监护室(PICU)患者的临床数据包含年龄、性别、实验室指标等多维度信息,对这些数据的深入分析可揭示关键指标与患者结局的关联。本项目基于13258条PICU患者数据,通过数据清洗、特征探索与逻辑回归建模,掌握临床数据处理核心流程,量化分析实验室指标与患者临床结局的关系,为临床风险评估提供数据支撑。
代码实现
编程库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from collections import Counter
import statsmodels.api as sm
from sklearn.metrics import roc_auc_score, roc_curve, auc
import matplotlib.pyplot as plt
1. 数据读取与预处理
筛选感兴趣的临床特征,为建模奠定基础。
path = "icu_first24hours.csv"
picu_data = pd.read_csv(path)
picu_data
# 筛选感兴趣的特征集(年龄、结局变量、关键实验室指标)
core_features = [
    'age_month', 'HOSPITAL_EXPIRE_FLAG',
    'lab_5097_max', 'lab_5099_min', 'lab_5237_min',
    'lab_5227_min', 'lab_5225_range', 'lab_5235_max', 'lab_5257_min'
]
new_picu_data = picu_data[core_features].copy()
2. 统计分析
数据集探索,将感兴趣的指标进行统计和可视化
# 查看各列的非空值数量 (count)
new_picu_data.count()
# 计算均值 (mean)
new_picu_data.mean()
# 计算中位数 (median)
new_picu_data.median()
# 计算方差 (var)
new_picu_data.var()
#new_picu_data.to_excel("data.xlsx", index=False)
| 变量 | 非空值数 (Count) | 均值 (Mean) | 中位数 (Median) | 方差 (Variance) |
|---|---|---|---|---|
| age_month | 13258 | 29.99 | 8.00 | 1939.01 |
| HOSPITAL_EXPIRE_FLAG | 13258 | 0.06 | 0.00 | 0.06 |
| lab_5097_max | 11346 | 38.27 | 36.90 | 80.80 |
| lab_5099_min | 11343 | 120.59 | 118.00 | 977.03 |
| lab_5237_min | 8668 | 7.35 | 7.37 | 0.01 |
| lab_5227_min | 8616 | 2.25 | 1.80 | 3.33 |
| lab_5225_range | 8666 | 3.84 | 1.50 | 29.85 |
| lab_5235_max | 8671 | 42.61 | 39.60 | 218.75 |
| lab_5257_min | 8662 | 91.55 | 105.00 | 3052.25 |
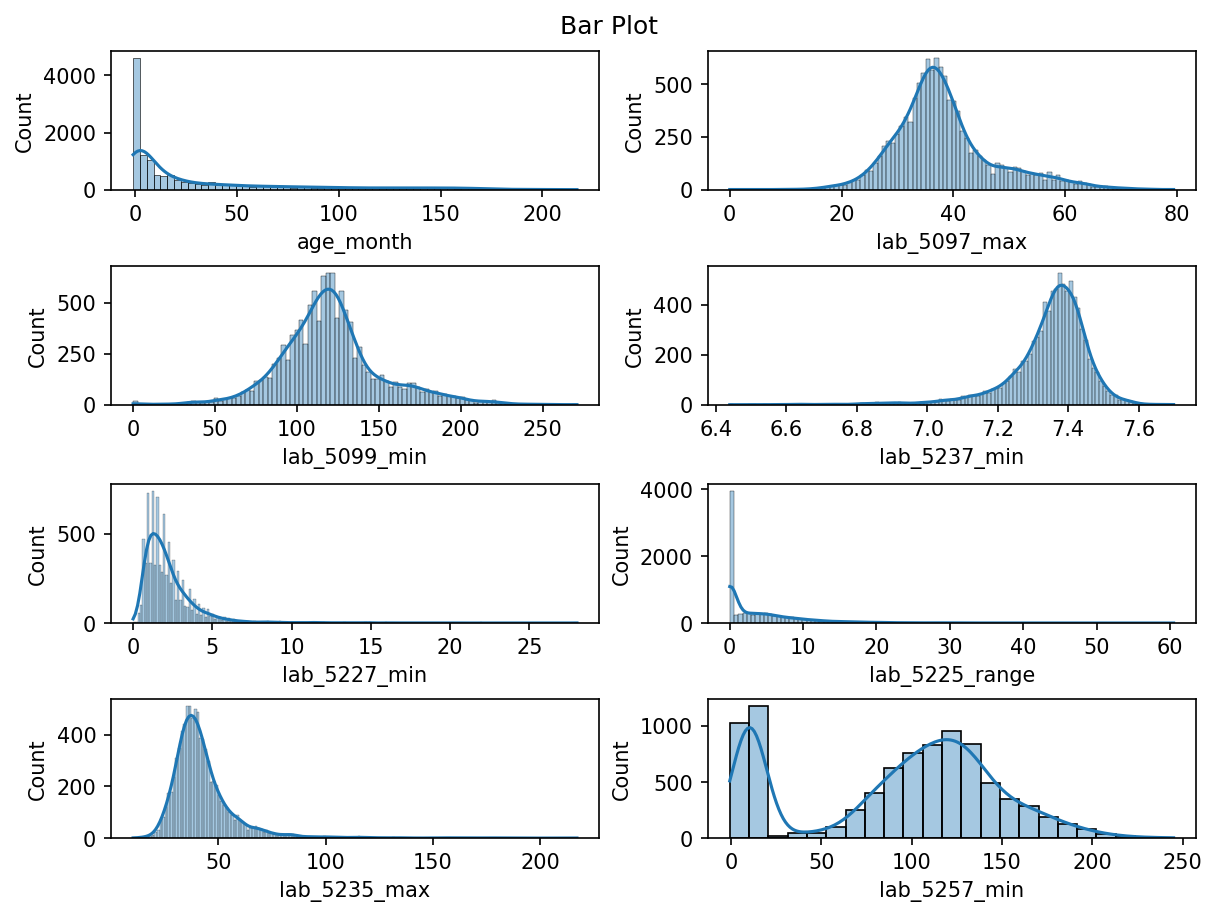
- 结局变量(HOSPITAL_EXPIRE_FLAG):HOSPITAL_EXPIRE_FLAG均值为 0.06,说明数据集内仅 6% 的患者住院期间死亡,数据存在明显的类别不平衡
- 年龄(age_month): 均值29.99个月,中位数仅8个月,说明PICU患者以低龄婴幼儿为主;
- 实验室指标: lab_5257_min方差(3052.25)远高于其他指标,提示该指标在患者间差异极大,可能是重要的预后特征。
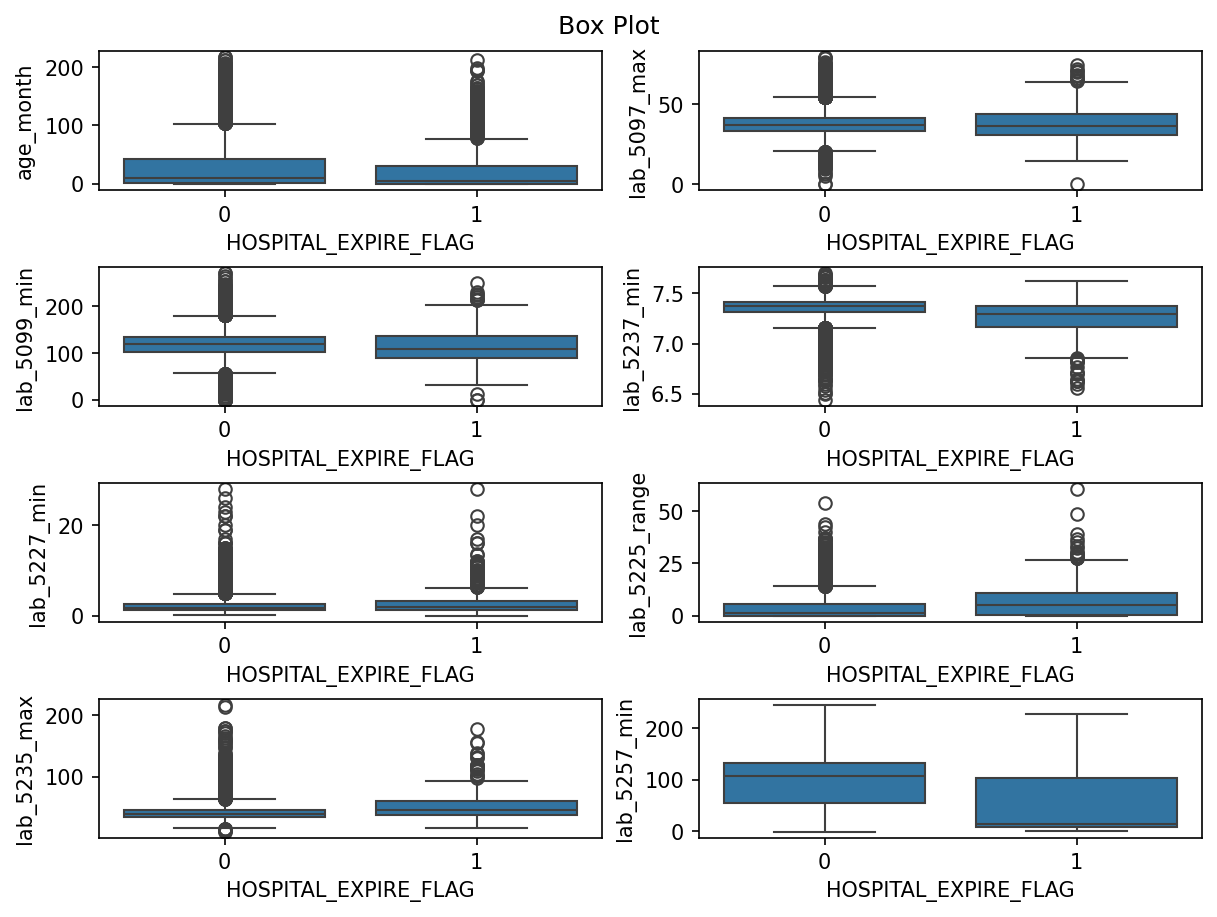
临床特征的直方图和箱线图展示
# === 直方图绘制代码 ===
# 定义要绘制直方图的列名列表,包含8个临床指标
colname =['age_month','lab_5097_max','lab_5099_min','lab_5237_min','lab_5227_min','lab_5225_range','lab_5235_max','lab_5257_min']

# 创建子图,共4行2列,使用seaborn的histplot函数绘制直方图
fig, axs = plt.subplots(int(len(colname)/2), 2, constrained_layout=True, figsize=(8, 6), dpi=150)

# 使用seaborn的histplot函数绘制直方图
for i in range(len(colname)):
    sns.histplot(x=colname[i], data=new_picu_data, alpha=0.4, kde=True, ax=axs[i//2, i%2])
plt.suptitle("Bar Plot")
# === 箱线图绘制代码) ===
# 创建一个新的图形对象和子图数组用于绘制箱线图
fig, axs = plt.subplots(
    int(len(colname) / 2), 2,
    constrained_layout=True,
    figsize=(8, 6),
    dpi=150
)
# 使用seaborn的boxplot函数绘制分组箱线图
for i in range(len(colname)):
    sns.boxplot(
        data=new_picu_data,
        x="HOSPITAL_EXPIRE_FLAG",
        y=colna
3. 构建逻辑回归模型
由于因变量是二分类,这里改为使用逻辑回归模型
#数据清洗,填补缺失值
picu_data_with_median = new_picu_data.fillna(new_picu_data.median())

# 自变量 X 和 因变量 y
X = picu_data_with_median.drop(columns="HOSPITAL_EXPIRE_FLAG")
y = picu_data_with_median["HOSPITAL_EXPIRE_FLAG"]

# 加截距项
X = sm.add_constant(X)

# Logistic 回归
logit_model = sm.Logit(y, X)
result = logit_model.fit()

# 提取回归系数和置信区间
params = result.params
conf = result.conf_int()
conf.columns = ['2.5%', '97.5%']

# 合并并指数化(得到 OR)
or_table = pd.concat([params, conf], axis=1)
or_table = np.exp(or_table)

# 重命名列
or_table.columns = ['OR', '2.5%', '97.5%']
# 去掉截距(
or_table = or_table.drop(index='const', errors='ignore')
# 保留两位小数
or_table = or_table.round(2)
# 按 OR 排序
or_table = or_table.sort_values(by='OR', ascending=False)
or_table
| 变量名 | OR | 2.5% | 97.5% |
|---|---|---|---|
| lab_5227_min | 1.05 | 1.01 | 1.09 |
| lab_5225_range | 1.03 | 1.02 | 1.05 |
| lab_5097_max | 1.01 | 1.00 | 1.03 |
| lab_5235_max | 1.01 | 1.00 | 1.01 |
| age_month | 1.00 | 0.998 | 1.00 |
| lab_5099_min | 1.00 | 0.99 | 1.00 |
| lab_5257_min | 0.99 | 0.99 | 0.99 |
| lab_5237_min | 0.08 | 0.03 | 0.22 |
在多因素 Logistic 回归分析中,lab_5237_min、lab_5257_min、lab_5227_min、lab_5225_range 为 HOSPITAL_EXPIRE_FLAG 的独立相关因素;其余变量在校正后未显示统计学显著性。
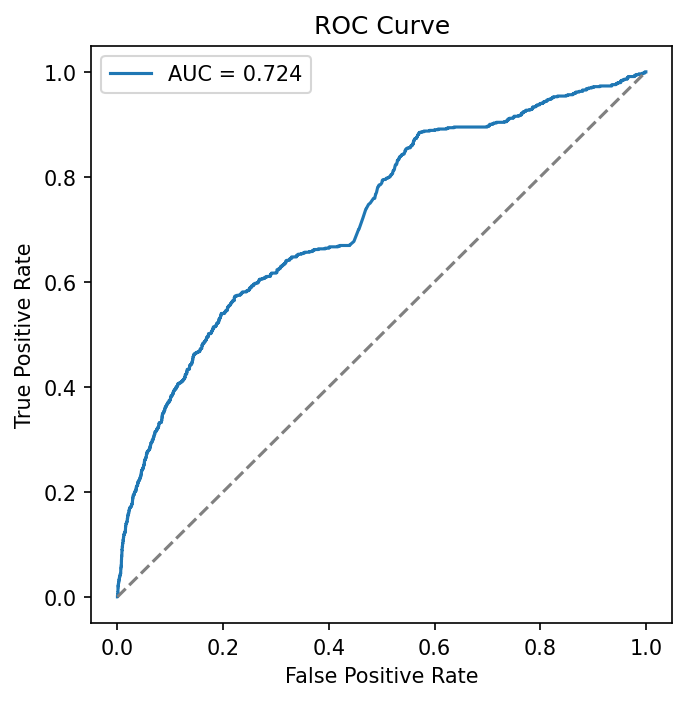
4. 预测模型评估与可视化
# 预测概率
y_pred_prob = result.predict(X)

# AUC
auc = roc_auc_score(y, y_pred_prob)
print("AUC =", auc)

# ROC 曲线
fpr, tpr, _ = roc_curve(y, y_pred_prob)

plt.figure(figsize=(5, 5), dpi=150)
plt.plot(fpr, tpr, label=f"AUC = {auc:.3f}")
plt.plot([0, 1], [0, 1], linestyle="--", color="gray")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve")
plt.legend()
plt.show()
5. 模型优化与展示
选择保留对预测结果影响较大的变量进行模型优化。我们选择了 lab_5237_min、lab_5257_min、lab_5227_min、lab_5225_range 作为预测模型中的独立相关因素。
selected_features = [
    'lab_5237_min',
    'lab_5227_min',
    'lab_5225_range',
    'lab_5235_max',
    'lab_5257_min'
]

# 构建新数据集
X = picu_data_with_median[selected_features]
y = picu_data_with_median['HOSPITAL_EXPIRE_FLAG']
X_const = sm.add_constant(X)
# 拟合模型
logit_model_reduced = sm.Logit(y, X_const)
result_reduced = logit_model_reduced.fit()

# 输出结果
y_pred_prob = result_reduced.predict(X_const)

params = result_reduced.params
conf = result_reduced.conf_int()
conf.columns = ['2.5%', '97.5%']

# 转换为 OR
or_df = pd.DataFrame({
    'OR': np.exp(params),
    '2.5%': np.exp(conf['2.5%']),
    '97.5%': np.exp(conf['97.5%'])
})

# 去掉截距
or_df = or_df.drop(index='const', errors='ignore')

# 保留两位小数
or_df = or_df.round(2)

or_df
| 变量名 | OR | 2.5% | 97.5% |
|---|---|---|---|
| lab_5237_min | 0.09 | 0.03 | 0.22 |
| lab_5227_min | 1.05 | 1.01 | 1.09 |
| lab_5225_range | 1.04 | 1.02 | 1.05 |
| lab_5235_max | 1.01 | 1.00 | 1.01 |
| lab_5257_min | 0.99 | 0.99 | 0.99 |
结果可视化
# y_true: 真实标签
# y_pred_prob: 预测概率(logit_model.predict())

fpr, tpr, thresholds = roc_curve(y, y_pred_prob)
roc_auc = auc(fpr, tpr)

plt.figure(figsize=(5, 5), dpi=150)

# ROC 曲线 —— 棕色
plt.plot(
    fpr, tpr,
    color='saddlebrown',
    lw=2,
    label=f'ROC curve (AUC = {roc_auc:.3f})'
)

# 对角线 —— 灰色
plt.plot(
    [0, 1], [0, 1],
    color='gray',
    lw=1.5,
    linestyle='--',
    label='Random'
)

plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve')
plt.legend(loc='lower right')
plt.grid(alpha=0.3)

plt.show()
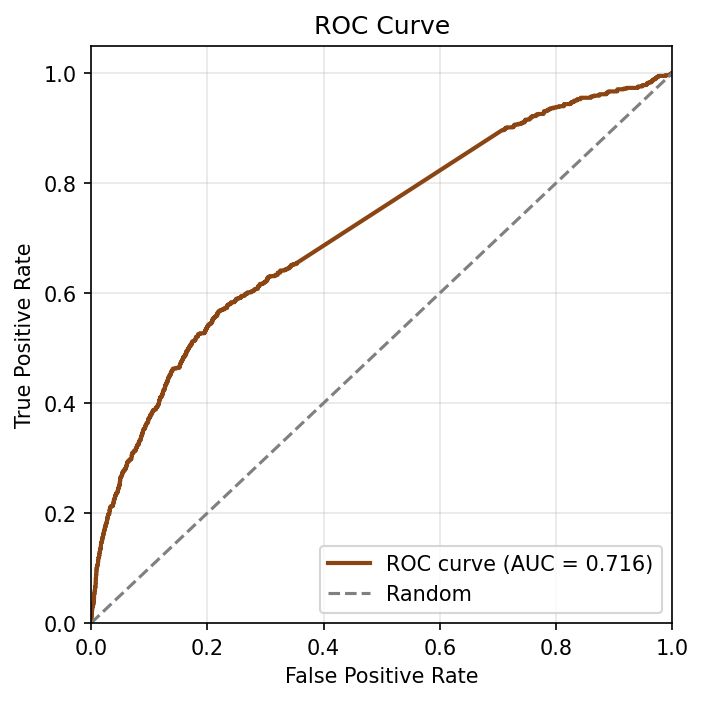
在剔除无显著意义的预测因子后,构建了一个简化的多变量逻辑回归模型。最终模型包含五个实验室检测得出的变量,并且对住院期间死亡率具有良好的判别能力(曲线下面积 AUC = 0.715)。所有保留下来的预测因子均与死亡率独立相关(p < 0.05)。