MNIST手写数字识别:CNN实战与性能优化
Published:
项目背景
PICU临床数据包含患者年龄、实验室指标等多维度信息,通过机器学习可实现两大核心目标:一是预测患者住院死亡风险(分类任务),辅助临床风险评估;二是基于实验室指标对患者进行无监督分组(聚类任务),挖掘潜在临床亚型。本项目基于13258条患者数据,系统实现数据预处理、多模型分类、K-Means聚类及效果评估,完整覆盖机器学习核心流程。
代码实现
编程库
fimport torch
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
import matplotlib.pyplot as plt
import torch.nn as nn
import torch.optim as optim
1. 数据读取
# 设置随机种子,确保结果可复现
torch.manual_seed(42)

# 定义数据预处理:转换为张量并标准化
transform = transforms.Compose([
    transforms.ToTensor(),  # 将图像转换为 Tensor,范围 [0, 1]
    transforms.Normalize((0.1307,), (0.3081,))  # MNIST 数据集的均值和标准差
])

# 下载并加载训练集和测试集
train_dataset = datasets.MNIST('data', train=True, download=True, transform=transform)
test_dataset = datasets.MNIST('data', train=False, transform=transform)

# 创建数据加载器
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=1000)
2. 数据统计分析
# 显示第一个训练样本的基本信息
first_img, first_label = train_dataset[0]
plt.imshow(first_img.squeeze(), cmap='grey')
print(f"\n第一个训练样本:")
print(f"  形状: {first_img.shape}")  # 输出: [1, 28, 28]
print(f"  标签: {first_label}")     # 输出: 0-9的数字
第一个训练样本: 形状: torch.Size([1, 28, 28]) 标签: 5 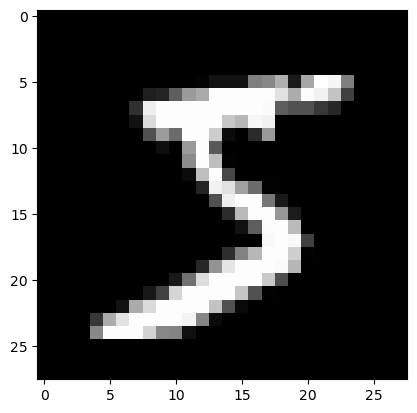
# 打印数据加载器基本信息
print(f"\n训练数据加载器:")
print(f"  批次大小: {train_loader.batch_size}")
print(f"  批次数: {len(train_loader)}")  # 总样本数/batch_size
print(f"  总样本数: {len(train_loader.dataset)}")

print(f"\n测试数据加载器:")
print(f"  批次大小: {test_loader.batch_size}")
print(f"  批次数: {len(test_loader)}")
print(f"  总样本数: {len(test_loader.dataset)}")
训练数据加载器: 批次大小: 64 批次数: 938 总样本数: 60000
测试数据加载器: 批次大小: 1000 批次数: 10 总样本数: 10000
# 检查第一个训练批次的形状
first_batch = next(iter(train_loader))
batch_imgs, batch_labels = first_batch
print(f"\n第一个训练批次:")
print(f"  图像批次形状: {batch_imgs.shape}")
print(f"  标签批次形状: {batch_labels.shape}")
第一个训练批次: 图像批次形状: torch.Size([64, 1, 28, 28]) 标签批次形状: torch.Size([64])
3. 预测模型建立
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        # 卷积层 1:输入通道=1(灰度图),输出通道=10,卷积核=5x5
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        # 卷积层 2:输入通道=10,输出通道=20,卷积核=5x5
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5)
        # 丢弃层:防止过拟合
        self.conv2_drop = nn.Dropout2d()
        # 全连接层
        self.fc1 = nn.Linear(320, 50)  # 320 = 20x4x4
        self.fc2 = nn.Linear(50, 10)   # 10 个类别

    def forward(self, x):
        # 输入图像尺寸:28x28
        x = self.conv1(x)  # 输出尺寸:(28-5+1) = 24x24
        x = nn.functional.relu(x)  # ReLU 激活
        x = nn.functional.max_pool2d(x, 2)  # 最大池化,尺寸减半:12x12

        x = self.conv2(x)  # 输出尺寸:(12-5+1) = 8x8
        x = self.conv2_drop(x)
        x = nn.functional.relu(x)
        x = nn.functional.max_pool2d(x, 2)  # 尺寸减半:4x4

        x = x.view(-1, 320)  # 展平为一维向量
        x = self.fc1(x)
        x = nn.functional.relu(x)
        x = nn.functional.dropout(x, training=self.training)
        x = self.fc2(x)
        return x  # 输出对数概率

# 实例化模型
model = SimpleCNN()

batch_pred = model(batch_imgs)
print(f"模型批次预测: {batch_pred.size()}")
4. 模型训练
#训练配置
epochs = 10
lr = 0.01
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=lr)

# 将模型设置为训练模式(启用Dropout等训练专用特性)
model.train()

# 外层循环控制训练轮数
for epoch in range(1, epochs + 1):
    print(f"\nEpoch {epoch}/{epochs}:")

    # 内层循环遍历数据加载器中的每个批次
    for batch_idx, (data, target) in enumerate(train_loader):
        # 1. 梯度清零:防止梯度累积(PyTorch默认会累加梯度)
        optimizer.zero_grad()

        # 2. 前向传播:将批次数据输入模型,得到预测结果
        output = model(data)

        # 3. 计算损失:对比预测结果与真实标签的差异
        loss = criterion(output, target)

        # 4. 反向传播:计算梯度(自动微分)
        loss.backward()

        # 5. 参数更新:根据优化器策略调整模型权重
        optimizer.step()

        # 每100个批次打印一次训练进度,监控训练过程
        if batch_idx % 100 == 0:
            print(f"  批次 {batch_idx}/{len(train_loader)} - 损失: {loss.item():.6f}")

print("\n[训练完成]")
5. 模型测试
# 设置为评估模式(关闭Dropout等训练专用层)
model.eval()

# 禁用梯度计算(节省内存,加速推理)
with torch.no_grad(): # with torch.inference_mode():
    test_loss = 0
    correct = 0

    # 遍历测试集
    for data, target in test_loader:
        # 前向传播
        output = model(data)

        # 累加批次损失
        test_loss += criterion(output, target).item()

        # 获取预测结果(概率最大的类别)
        pred = output.argmax(dim=1, keepdim=True)

        # 统计正确预测的样本数
        correct += pred.eq(target.view_as(pred)).sum().item()

# 计算平均损失和准确率
test_loss /= len(test_loader.dataset)
accuracy = 100. * correct / len(test_loader.dataset)

# 打印评估结果
print(f"\n测试集评估结果:")
print(f"  平均损失: {test_loss:.4f}")
print(f"  准确率: {correct}/{len(test_loader.dataset)} ({accuracy:.2f}%)")
测试集评估结果: 平均损失: 0.0001 准确率: 9769/10000 (97.69%)
6. 结果可视化
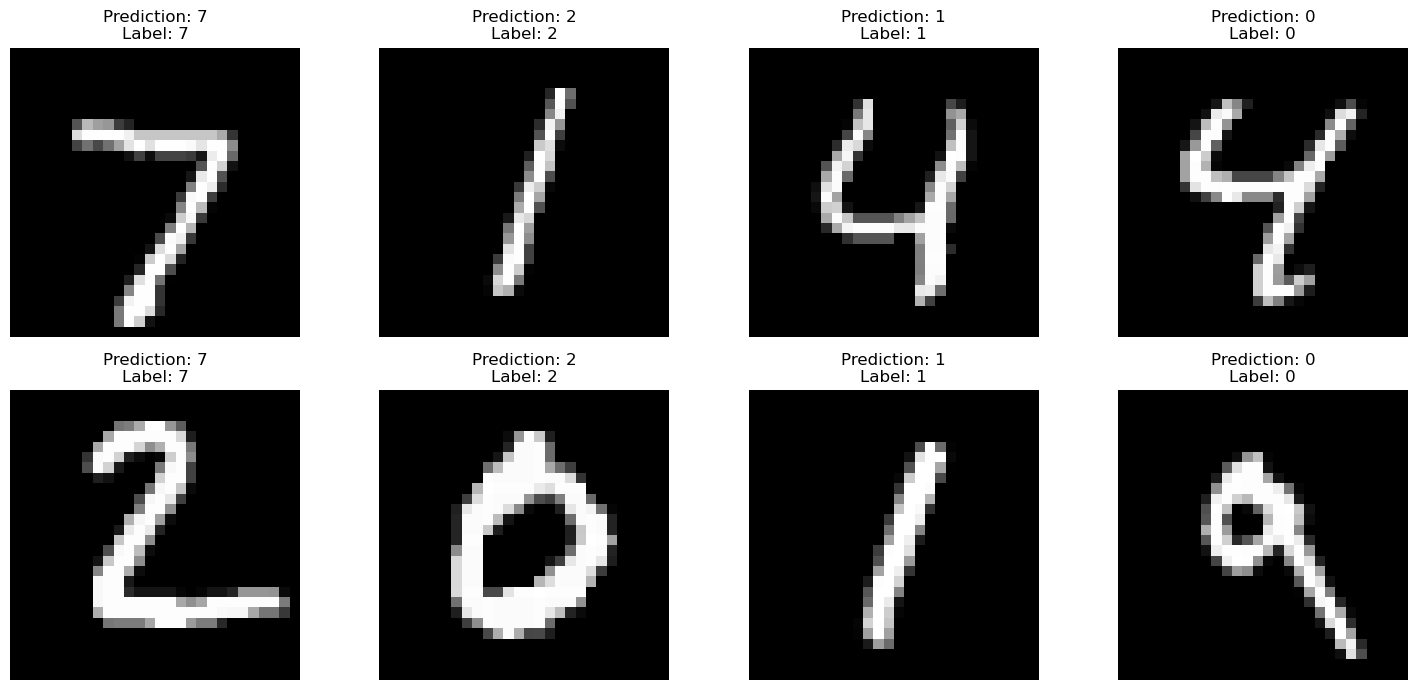
# ================ 可视化预测结果 ================
def visualize_predictions(model, num_samples=5):
    """可视化模型对测试集的预测结果"""
    model.eval()

    # 随机选择样本
    samples = next(iter(test_loader))
    data, target = samples[0][:num_samples], samples[1][:num_samples]

    # 获取预测结果
    with torch.no_grad():
        output = model(data)
        pred = output.argmax(dim=1)

    # 绘制图像与预测结果
    fig, axes = plt.subplots(2, num_samples//2, figsize=(15, 7))
    for i in range(num_samples//2):
        for j in range(2):
            # 恢复图像的原始形态(去标准化)
            img = data[i*2+j].squeeze().numpy()
            img = img * 0.3081 + 0.1307  # 反标准化

            # 显示图像与预测结果
            axes[j][i].imshow(img, cmap='gray')
            axes[j][i].set_title(f'Prediction: {pred[i]}\nLabel: {target[i]}')
            axes[j][i].axis('off')

    plt.tight_layout()
    plt.show()

# 可视化预测结果
visualize_predictions(model, num_samples=8)
# ================ 混淆矩阵 ================
def plot_confusion_matrix(model):
    """绘制混淆矩阵,展示模型对每个类别的分类效果"""
    from sklearn.metrics import confusion_matrix
    import seaborn as sns

    model.eval()
    all_preds = []
    all_targets = []

    with torch.no_grad():
        for data, target in test_loader:
            output = model(data)
            preds = output.argmax(dim=1)
            all_preds.extend(preds.cpu().numpy())
            all_targets.extend(target.cpu().numpy())

    # 计算混淆矩阵
    cm = confusion_matrix(all_targets, all_preds)

    # 绘制热力图
    plt.figure(figsize=(10, 8), dpi=300)
    sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
                xticklabels=range(10), yticklabels=range(10))
    plt.xlabel('Predicted labels', fontsize=16)
    plt.ylabel('Actual labels', fontsize=16)
    plt.title('Confusion matrix', fontsize=16)
    plt.show()

plot_confusion_matrix(model)